Textcodierung
Wir haben bereits mehrfach festgestellt, dass Computer nur Binärzahlen speichern können. Text war jedoch schon seit der Erfindung von Computerprogrammen ein wichtiger Bestandteil von Computeranwendungen – zum Beispiel als Ablösung der mechanischen Schreibmaschine.
Im Folgenden schauen wir uns an, wie Buchstaben und Texte verarbeitet werden, damit sie ein Computer speichern und versenden kann.
💡 Zum Einstieg gibt es eine Präsentation zum Durchklicken.
Einführendes Beispiel: Brailleschrift
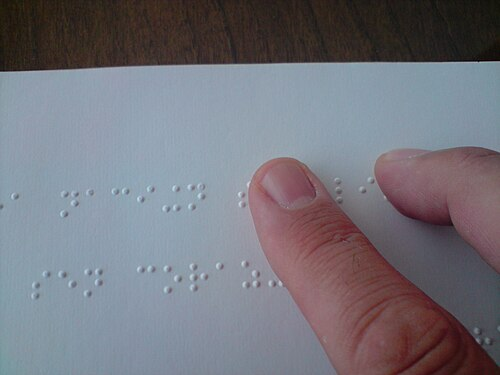
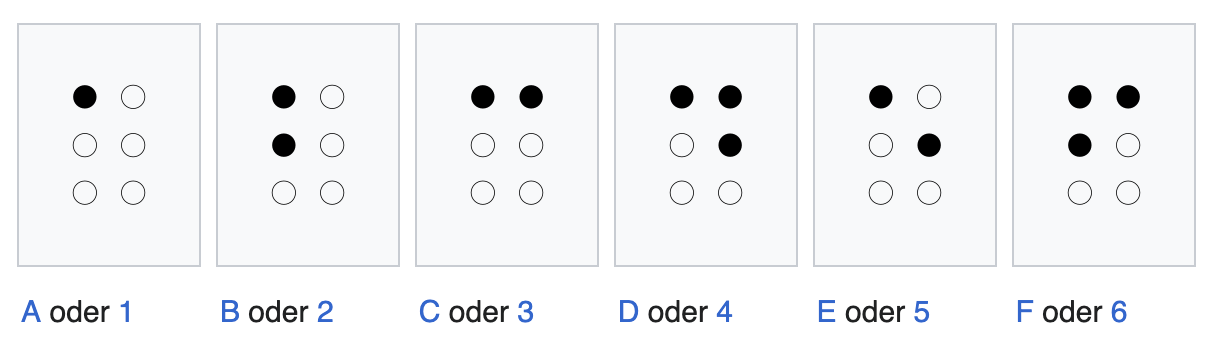
Die Brailleschrift ist ein haptisches Schriftsystem, bei dem Texte durch Punktmuster auf erhabenen Oberflächen dargestellt werden. Jeder Buchstabe wird durch eine Kombination von 1 bis 6 Punkten repräsentiert.
Im folgenden Bild siehst du die Buchstaben A bis F. Ein gefüllter Punkt bedeutet «gehoben», ein leerer «flach»:
Probier es gleich selbst aus: Klick die Punkte an, um ein Muster zu bilden – oder wähle einen Buchstaben, um sein Muster zu sehen.
Jeder der 6 Punkte ist entweder gehoben oder flach – genau zwei Zustände, wie ein Bit. Damit gibt es 2⁶ = 64 mögliche Muster. Genug für das ganze Alphabet, Zahlen und Satzzeichen.
Eine vollständige Liste der Schriftzeichen findest du übrigens hier.
Obwohl Brailleschrift natürlich nicht von Computern verwendet wird, ist sie den echten Textcodierungssystemen sehr nah. Erkennst du eine Eigenschaft dieser Schrift, die sie für den Computer bestens geeignet macht? Nimm dir ein paar Minuten Zeit, darüber nachzudenken. Beantworte ausserdem folgende Fragen:
- Wie viele Zeichen (z.B. Buchstaben, Sonderzeichen) können mit der Brailleschrift codiert werden?
- Wie könnte man Gross- und Kleinbuchstaben einfach unterscheiden?
Falls du die Fragen nicht beantworten kannst, suche im Internet nach möglichen Antworten.
ASCII: Eine erste Textcodierung
ASCII (American Standard Code for Information Interchange) ist ein 7-Bit-Zeichencodierungsstandard, der 1963 entwickelt wurde. Da die Codierung 7 Bit pro Zeichen verwendet, können damit 01000001 ergibt.
Klick dich durch die Tabelle und schau dir für jedes Zeichen die Dezimal-, Hex- und Binärdarstellung an:
ASCII belegt die Zahlen 0–127. Die Codes 0–31 sind unsichtbare Steuerzeichen (z.B. Zeilenumbruch), 32–126 sind sichtbare Zeichen. Für jedes reichen 7 Bit (2⁷ = 128).
ASCII war der erste weit verbreitete Standard zur digitalen Textdarstellung, hat aber Einschränkungen: Es unterstützt nur das lateinische Alphabet und eine begrenzte Zeichenauswahl. Mit der Verbreitung des Internets um 1990 gab es immer mehr Probleme damit. Jede Sprachregion hatte eigene Textcodierungen – so konnten zum Beispiel Texte, die in Japan geschrieben wurden, in Europa nicht gelesen werden (und umgekehrt).
Unicode: Weltweite Textcodierung
So entwickelte sich zunehmend der Bedarf für eine eindeutige, weltweit funktionierende Textcodierung. Im Jahr 1991 wurde schlussendlich Unicode vorgeschlagen. Diese neue Codierung hat sich in den darauffolgenden Jahren zum weltweiten Standard entwickelt. Heute umfasst Unicode über 150'000 Zeichen aus Sprachen der ganzen Welt.
Jedes Zeichen hat eine eindeutige Unicode-Nummer, die häufig als Hexadezimalzahl dargestellt wird (um sie abzukürzen). Das Konzept ist also sehr ähnlich wie bei ASCII: eine (sehr grosse) Tabelle, die jedem Zeichen eine Zahl zuordnet. Der einzige Unterschied ist, dass Unicode nicht auf 128 Zeichen limitiert ist. Eine vollständige Liste findest du hier.
Interessant ist: Damit alte ASCII-Texte weiterhin gelesen werden können, haben die 128 Zeichen von ASCII im Unicode dieselbe Zahl bekommen. ASCII-Texte sind also vollständig mit Unicode kompatibel.
UTF-8: Vom Zeichen zu Binär
UTF-8 ist ein Code, der Unicode-Zeichen in Bits übersetzt. Ein Unicode-Zeichen wird dabei mit ein bis vier Byte dargestellt.
| Zeichen | Unicode-Nummer | UTF-8-Bitmuster |
|---|---|---|
| A | 65 | 01000001 |
| ä | 228 | 11000011 10100100 |
| ☀ (Sonne) | 9728 | 11100010 10011000 10000000 |
| 🐒 (Affe) | 128018 | 11110000 10011111 10010000 10010010 |
Im Beispiel oben siehst du, dass Zeichen unterschiedlich viele Bytes benötigen (A → 1, ä → 2, 🐒 → 4). Schau dir die ersten Bits jedes Bitmusters an – erkennst du einen Zusammenhang?
Wie du vielleicht bemerkt hast, entspricht die Anzahl der 1er am Anfang des ersten Bytes der Anzahl Bytes (ausser bei Zeichen mit nur einem Byte, das mit 0 beginnt). Jedes Folgebyte beginnt mit 10. Probier es selbst aus – die orange markierten Bits sind diese Markierungs-Bits, der Rest trägt die eigentliche Zeichen-Information:
Markierungs-Bits · Nutz-Bits (die eigentliche Zeichen-Information)
Trick: Die Anzahl der führenden 1er im ersten Byte (hier 2) verrät, aus wie vielen Bytes das Zeichen besteht. Jedes Folgebyte beginnt mit «10».
Diese schlaue Codierung hat viele Vorteile. Sie spart zum Beispiel viele Daten, da die häufigsten Zeichen (die lateinischen Buchstaben) nur ein einziges Byte benötigen. UTF-8 ist heute der am weitesten verbreitete Zeichencodierungsstandard und wird auf fast allen Webseiten und Apps verwendet.
Zum Schluss kannst du hier eigenen Text (auch Umlaute oder Emojis) direkt in seine Bits zerlegen lassen:
Jedes Zeichen wird über Unicode/UTF-8 zu einem oder mehreren Bytes – und jedes Byte sind 8 Bit (0 oder 1).
Zusammenfassung
Ein internationaler Codierungs-Standard ist extrem wichtig, damit Daten auf allen Computern der Erde dargestellt werden können. Ganz einfach ausgedrückt geht es nur darum, dass sich alle einig sind, welches Zeichen (z.B. «A») in welche Zahl (z.B. 65) und somit in welches Bit-Muster übersetzt wird.
ASCII war der erste Standard, dem diese Aufgabe einigermassen gelang. Da ASCII allerdings auf 128 Zeichen begrenzt ist, hat es keine Chance, all die Sprachen mit anderen Schriftzeichen darzustellen. Unicode hat sich der Aufgabe angenommen, allen Schriftzeichen der Welt eine eindeutige Zahl zuzuordnen. UTF-8 übersetzt die Unicode-Zeichen schliesslich in Bits. Durch die clevere Codierung mit unterschiedlich vielen Bytes kann die Menge an Zeichen laufend erweitert werden.
Das folgende Video beleuchtet die Funktionsweise dieser Codierungen auf brillante Weise und erwähnt noch weitere spannende Details. Zum Beispiel wird gezeigt, wie genial Unicode die Weiterverwendung von ASCII ermöglicht. 🧠
https://www.youtube.com/watch?v=MijmeoH9LT4
Teste dich selbst
Selbsttest: Textcodierung
Frage 1 von 5
Aufgaben
Löse die Aufgaben und überprüfe erst danach deine Lösung im Dropdown. Die ASCII-Tabelle oben darf dir dabei helfen.
Aufgabe 1: Der Buchstabe «A» hat den ASCII-Code 65. Wie lautet er als 8-Bit-Binärzahl?
Lösung anzeigen
01000001.
Aufgabe 2: Wie viele verschiedene Zeichen könnte man mit 8 Bit statt 7 Bit darstellen?
Lösung anzeigen
Aufgabe 3: Das Wort «Hallo» besteht aus 5 Buchstaben, die alle im ASCII-Bereich liegen. Wie viele Bytes braucht es in UTF-8?
Lösung anzeigen
5 Bytes – jedes ASCII-Zeichen braucht in UTF-8 genau 1 Byte.
Aufgabe 4: Das Zeichen «ä» wird in UTF-8 als 11000011 10100100 gespeichert. Woran erkennt der Computer, dass es aus 2 Bytes besteht?
Lösung anzeigen
An den zwei führenden 1ern im ersten Byte (110…). Das zweite Byte beginnt mit 10 und wird dadurch als Folgebyte erkannt.
Aufgabe 5: Warum ist UTF-8 sparsamer als eine Codierung, die jedes Zeichen fest mit 4 Byte speichert?
Lösung anzeigen
Weil die häufigsten Zeichen (z.B. die lateinischen Buchstaben) in UTF-8 nur 1 Byte brauchen. Nur seltene Zeichen benötigen 2 bis 4 Byte. Bei einer festen 4-Byte-Codierung würde jeder Buchstabe unnötig viel Platz belegen.